16
novembre
2026
Gemini devant la CJUE : quand un résumé devient-il une reproduction ?
Author:
TAoMA
Le 3 novembre 2026, l’avocat général Szpunar a présenté ses conclusions dans l’affaire C-250/25, Like Company c. Google Ireland1, la première affaire relative à l’IA générative soumise à la Cour de justice de l’Union européenne (CJUE). Sa grille de lecture: l’information est libre, la forme d’expression des articles de presse ne l’est pas.
Un résumé d’article généré par Gemini est à l’origine de la première affaire d’IA générative devant la CJUE
Like Company, société hongroise exploitant plusieurs sites d’information, invoque le droit voisin des éditeurs de presse prévu à l’article 15, paragraphe 1, de la directive (UE) 2019/790, dite «CDSM ». Ce droit leur permet de contrôler la reproduction et la mise à disposition en ligne de leurs publications par les prestataires de services de la société de l’information.
Interrogé par un utilisateur, Gemini, l’agent conversationnel de Google reposant sur des grands modèles de langage (« LLM »), avait fourni un résumé d’un article de Like Company consacré au projet d’un chanteur hongrois d’introduire des dauphins dans le lac Balaton. L’éditeur y voyait la preuve que ses articles avaient servi à entraîner Gemini, et que la réponse constituait une reproduction et une mise à disposition non autorisées de son article.
Le litige vise donc deux utilisations distinctes :
• en amont, l’entraînement des modèles Gemini ;
• en aval, la récupération des articles en temps réel par le « RAG » (Retrieval-Augmented Generation) : le chatbot recherche une source pertinente sur Internet, intègre son contenu aux données transmises au LLM, puis génère sa réponse.
Le tribunal régional de Budapest a posé quatre questions à la Cour :
la réponse du chatbot constitue-t-elle une mise à disposition du public (question 1) ?
L’entraînement d’un LLM est-il une reproduction (question 2)
couverte par l’exception de fouille de textes et de données, dite « TDM » (question 3) ?
Les reproductions contenues dans les réponses sont-elles imputables au fournisseur du chatbot (question 4) ?
Ces conclusions ne lient pas la Cour : elles lui proposent une interprétation.
Les questions relatives à l’entraînement sont jugées hypothétiques, mais l’avocat général y répond à titre subsidiaire
L’avocat général propose de déclarer les questions 2 et 3 irrecevables, pour deux raisons :
• rien ne permet de supposer que les articles de Like Company ont servi à entraîner Gemini. L’article litigieux a été publié le 21 juillet 2023, quelques mois seulement avant le lancement de Gemini 1.0 en décembre 2023. L’explication la plus vraisemblable est que Gemini l’a récupéré en temps réel grâce au RAG, d’autant que l’utilisateur avait cité le nom du site dans sa requête ;
• en tout état de cause, l’entraînement, réalisé en amont sur une infrastructure dédiée, n’est pas une « utilisation en ligne » au sens de l’article 15 de la directive CDSM et échappe donc au droit voisin des éditeurs de presse.
Compte tenu de leur importance, il examine néanmoins ces questions, en précisant n’exprimer parfois qu’un point de vue provisoire.
L’entraînement implique des reproductions, mais peut bénéficier de l’exception TDM sous conditions
Selon l’avocat général, l’entraînement implique bien des actes de reproduction au sens de l’article 2 de la directive 2001/29/CE, dite « InfoSoc » : lors du scraping (collecte automatisée de contenus en ligne), du prétraitement (nettoyage, conversion et « tokenisation » des textes) et, sous forme de copies temporaires en mémoire, pendant l’entraînement lui-même. Peu importe que ces copies soient purement techniques : le législateur a retenu une approche technique, et non fonctionnelle, de la reproduction.
Le modèle entraîné, en revanche, n’est pas une base de données : il contient des paramètres numériques reflétant des relations statistiques entre les mots. L’avocat général invite à « la plus grande prudence » avant d’y voir des copies des œuvres. Lorsqu’un modèle restitue une œuvre mot pour mot ou presque, c’est la sortie elle-même qui peut constituer une reproduction, à apprécier au cas par cas. Une approche plus prudente que celle du Landgericht München I (tribunal régional de Munich), qui a jugé le 11 novembre 2025, dans l’affaire GEMA c. OpenAI2, que la mémorisation de paroles de chansons au sein d’un LLM pouvait constituer une reproduction.
L’entraînement entre en principe dans la définition large de la fouille de textes et de données (article 2 de la directive CDSM) : le système analyse automatiquement un vaste corpus pour en dégager des informations, à savoir des schémas statistiques entre les mots. Le règlement sur l’intelligence artificielle (« AI Act ») le confirme, en son considérant 105 et en son article 53, paragraphe 1, c), même s’il n’est pas applicable dans le temps au litige.
L’exception TDM (article 4 de la directive CDSM) n’est toutefois acquise qu’à deux conditions :
• les œuvres doivent être accessibles de manière licite, ce qui interdit au moins de puiser dans des sources manifestement illicites, comme des sites pirates ;
• le titulaire ne doit pas avoir exercé son « opt-out », c’est-à-dire réservé ses droits de manière appropriée, notamment par des procédés lisibles par machine.
Le « test en trois étapes », qui encadre les exceptions au droit d’auteur, ne s’oppose pas, selon lui, à cette interprétation. Il estime néanmoins que l’on peut attendre des développeurs qu’ils prennent des mesures appropriées (déduplication des données, filtres sur les prompts et les sorties, etc.) pour éviter que leur modèle ne reproduise trop fidèlement ses données d’entraînement.
L’application du droit européen à l’entraînement réalisé à l’étranger reste incertaine
Les modèles Gemini ont principalement été entraînés aux États-Unis. La plupart des gouvernements intervenants soutenaient que la seule commercialisation du modèle dans l’Union suffisait à soumettre son entraînement au droit européen. L’avocat général se montre réservé : les effets de l’entraînement sur le marché européen sont trop indirects au regard du principe de territorialité. Il n’exclut pas la piste du gouvernement allemand, qui consisterait à appliquer le droit de l’Union au scraping de contenus hébergés sur des serveurs situés dans l’Union, mais estime préférable que le législateur de l’Union tranche expressément la question.
Le RAG relève bien du droit voisin des éditeurs de presse
Contrairement à l’entraînement, la récupération d’un article en temps réel pour répondre à un utilisateur constitue une « utilisation en ligne » au sens de l’article 15 de la directive CDSM.
Cette récupération implique des copies techniques de l’article. L’exception TDM ne s’applique pas ici, car le RAG ne vise pas à extraire des informations d’un vaste corpus, mais à récupérer un contenu précis pour répondre à une question précise. Ces copies peuvent en revanche relever de l’exception de copies provisoires (article 5, paragraphe 1, de la directive InfoSoc), à condition que le chatbot ait accédé licitement à l’article, sans contourner les mesures techniques mises en place par l’éditeur (paywall, blocage des robots), et que sa réponse ne reproduise pas l’article.
Un chatbot peut reprendre les faits, mais pas la forme d’un article au point de s’y substituer
C’est le point central des conclusions : le droit voisin ne confère aux éditeurs aucun monopole sur l’information. Il protège la forme d’expression de l’article, c’est-à-dire son agencement, sa structure et sa formulation.
Une reproduction suppose donc que l’article ait été utilisé pour produire la réponse et que des éléments de sa forme y soient « reconnaissables ». Une simple paraphrase n’y échappe pas automatiquement : le droit voisin serait sinon trop facile à contourner. Le critère décisif proposé est celui de la substitution : en lisant la réponse, l’utilisateur peut-il se dispenser entièrement de consulter l’article original ? À l’inverse, un bref résumé présenté différemment, ou une synthèse de plusieurs sources, peut rester licite dès lors qu’il ne reprend pas la forme d’expression protégée. L’appréciation se fait au cas par cas.
Il n’y a par ailleurs mise à disposition du public que si la forme de l’article est systématiquement reconnaissable dans les réponses du chatbot à des requêtes similaires. Compte tenu du caractère aléatoire des réponses des chatbots, c’est peu probable, et il appartient à l’éditeur de le démontrer par un nombre suffisant d’exemples.
Le fournisseur du chatbot n’est responsable que s’il a facilité l’atteinte ou manqué de diligence
Lorsque l’utilisateur demande lui-même une utilisation particulière, la responsabilité principale lui incombe en général. Imputer automatiquement chaque réponse au fournisseur serait excessif et freinerait l’innovation. Cette responsabilité principale de l’utilisateur ne signifie toutefois pas que le droit voisin de l’éditeur puisse être invoqué contre lui : les utilisations privées ou non commerciales effectuées par des utilisateurs individuels sont exclues du droit prévu à l’article 15 de la directive CDSM.
Le fournisseur peut toutefois être considéré comme l’auteur des actes lorsqu’il intervient délibérément pour les faciliter, notamment :
• lorsque la reproduction ou la mise à disposition de contenus protégés est inhérente à son modèle économique ;
• lorsqu’il n’a pas adopté les mesures qu’un opérateur raisonnablement diligent aurait prises pour prévenir les atteintes, par exemple respecter les restrictions anti-scraping des éditeurs et filtrer les réponses trop proches des articles récupérés.
Si ces mesures existent, il ne répond pas des reproductions occasionnelles.
Laisser ses articles en libre accès ne vaut pas consentement à leur réutilisation par un chatbot
Google soutenait qu’un éditeur qui laisse ses contenus librement accessibles, sans paywall ni blocage des robots, consent implicitement à leur utilisation par les chatbots. L’avocat général rejette cet argument. Un consentement implicite suppose que l’éditeur ait été effectivement et individuellement informé de l’utilisation et dispose de moyens simples pour s’y opposer. Or, le paywall est un choix commercial lourd, et bloquer les robots peut nuire au référencement : chez Google, les mêmes robots servent à la fois à l’indexation et au RAG.
Sur les faits de l’espèce, l’avocat général penche en faveur de Google
L’avocat général propose à la Cour de déclarer les questions 2 et 3 irrecevables et de juger, sur les questions 1 et 4, qu’un chatbot reproduit une publication de presse s’il y a accédé illicitement, notamment en contournant des mesures techniques, ou si sa forme d’expression est reconnaissable dans la réponse au point de s’y substituer. Il la met à disposition du public si cette forme est systématiquement reconnaissable, et ces actes sont imputables au fournisseur s’ils sont inhérents à son modèle économique ou s’il a manqué de diligence.
Sous réserve des vérifications du juge hongrois, ces conditions ne paraissent pas remplies en l’espèce :
• Like Company ne semble pas avoir mis en place de mesures techniques efficaces contre l’accès ou le scraping ;
• la forme d’expression de l’article ne paraît pas reconnaissable dans la réponse de Gemini ;
• les éventuelles reproductions ne paraissent pas inhérentes au modèle économique de Google ;
• Google semble avoir mis en place des mesures appropriées pour en limiter le risque.
Si la Cour suit son avocat général, les éditeurs ne pourront pas revendiquer de monopole sur l’information, mais disposeront de leviers distincts face aux chatbots : l’opt-out, qui écarte l’exception TDM applicable à l’entraînement ; la protection technique de l’accès à leurs contenus, qui intervient dans l’analyse des reproductions techniques liées au RAG ; et la documentation des réponses qui se substituent à leurs articles.
Anne MESSAS
Avocate à la Cour -Médiatrice Associée
Mathilde MUNSCH
Stagiaire Pôle Avocat
Contactez TAoMA pour obtenir des conseils personnalisés ici.
Besoin de vous former ou de former vos équipes aux bonnes pratiques sur le sujet ?
Découvrez les ateliers de TAoMA Academy en nous contactant ici.
Notes de référence :
1) CJUE, aff. C-250/25, Like Company c. Google Ireland, conclusions de l’avocat général M. Szpunar présentées le 3 novembre 2026
2) Landgericht München I (tribunal régional de Munich), 11 novembre 2025, GEMA c. OpenAI, n° 42 O 14139/24
NB. Oui, l’IA nous aide. Non, on ne lui a pas laissé les clés du cabinet. À chaque étape, un humain pense, oriente, vérifie, reformule et valide.
Crédit photo : Mohamed Nohassi
24
juin
2025
Piraterie en ligne : les fournisseurs d’accès contraints au blocage
Author:
TAoMA
Une décision importante du Tribunal judiciaire de Paris contre le streaming illégal
Le Tribunal judiciaire de Paris vient de rendre une décision forte contre les sites diffusant illégalement des œuvres audiovisuelles. Par un jugement du 10 avril 2025, les juges ordonnent aux principaux fournisseurs d’accès à Internet de bloquer plusieurs plateformes de streaming illégal, renforçant ainsi la responsabilité des intermédiaires dans la lutte contre la contrefaçon.
Des plateformes visées pour contrefaçon massive
À l’initiative de plusieurs syndicats et sociétés de l’audiovisuel, dont la FNEF, le SEVN, l’API, le SPI, l’UPC, Gaumont, Paramount, ainsi que du CNC, une action a été engagée contre les FAI Bouygues Télécom, Free, Orange, SFR et SFR Fibre.
Quatorze sites – parmi lesquels Wiflix, Enstream et Torrent9 – étaient accusés de proposer massivement des œuvres protégées sans autorisation. Le tribunal a constaté, notamment sur la base des procès-verbaux de l’ALPA, que plus de 60 % à 99 % des contenus accessibles étaient contrefaisants, attirant parfois des centaines de milliers d’internautes.
Un dispositif de blocage encadré mais ferme
En application de l’article L. 336-2 du Code de la propriété intellectuelle, le tribunal a ordonné aux FAI de bloquer les noms de domaine litigieux et leurs sous-domaines dans un délai de 15 jours suivant la signification du jugement, pour une durée de 18 mois.
La juridiction précise que ces mesures doivent être efficaces mais proportionnées, conformément à la jurisprudence de la CJUE (Scarlet Extended, C-70/10) :
• Ne pas porter atteinte de manière disproportionnée à la liberté d’information des internautes ;
• Ni à la liberté d’entreprendre des fournisseurs d’accès.
Un signal fort contre les sites anonymes
Le tribunal relève également que les sites en cause se maintiennent dans l’anonymat, utilisent des hébergeurs comme Cloudflare et rendent impossible toute action directe.
Face à cette opacité, les FAI deviennent le levier opérationnel le plus efficace pour limiter l’accès à ces plateformes.
Vers un nouveau modèle de responsabilisation des intermédiaires techniques ?
Cette décision illustre la montée en puissance des actions judiciaires visant les intermédiaires techniques. Lorsqu’une atteinte aux droits d’auteur est avérée, ces acteurs peuvent être sommés d’intervenir, même s’ils ne sont pas à l’origine des contenus en cause.
À retenir pour les titulaires de droits
Ce jugement ouvre une voie claire : face à des sites anonymes, le blocage par les FAI reste une arme efficace pour endiguer la diffusion d’œuvres piratées.
Mais cette efficacité suppose un suivi actif, notamment en cas de reconstitution des sites sous d’autres noms de domaine.
• pour les titulaires de droits : vigilance et réactivité restent les clés ;
• pour les intermédiaires : la neutralité technique ne suffit plus à exonérer toute responsabilité.
Contactez TAoMA pour obtenir des conseils personnalisés ici.
Besoin de vous former ou de former vos équipes aux bonnes pratiques sur le sujet ?
Découvrez les ateliers de TAoMA Academy en nous contactant ici.
Gaëlle Loinger-Benamran
CPI et Associée
05
mai
2025
Quand le passé ne s’efface pas : la liberté d’informer prime sur le droit à l’oubli
Author:
TAoMA
Peut-on obtenir la suppression de son nom dans un article en ligne, des années après une condamnation pénale ? La Cour d’appel de Paris répond non, au nom de la liberté d’informer. Dans un arrêt rendu le 20 février 20251, elle rappelle avec fermeté que la liberté d’expression et d’information peut primer sur le droit à l’effacement des données, même plusieurs années après les faits.
Un affrontement classique : vie privée vs. mémoire publique
M. X., ancien dirigeant d’un club de football francilien, avait été condamné en 2009 pour des faits de détournement de fonds. En 2020, il a demandé à la société 20 Minutes France la suppression, anonymisation ou désindexation d’un article relatant sa condamnation, sur le fondement des articles 17 et 21 du RGPD, qui encadrent le droit à l’oubli.
Malgré une mise à jour de l’article en 2019 mentionnant l’arrêt d’appel de 2011 ayant partiellement infirmé le jugement initial, M. X. estimait que son nom devait être retiré, les faits n’ayant, selon lui, “plus d’intérêt informatif”.
Une décision sans ambiguïté
La Cour est catégorique : toutes les demandes sont rejetées. Elle considère que la condamnation, bien qu’ancienne, reste liée à un sujet d’intérêt général : la gestion des fonds publics dans le sport associatif.
M. X. conserve une certaine notoriété, étant donné ses fonctions sportives passées et sa présence médiatique. De plus, le maintien de son nom est essentiel à la compréhension du contenu : une anonymisation priverait l’article de son intérêt informatif.
Enfin, le préjudice allégué (frein à la reconversion professionnelle) n’est pas établi. M. X. a retrouvé un emploi malgré la publication de l’article.
La liberté de la presse réaffirmée
Cette affaire rappelle que l’article 17.3 a) du RGPD exclut le droit à l’effacement lorsque le traitement est nécessaire à l’exercice de la liberté d’expression et d’information. La Cour insiste : la presse joue un rôle central dans le débat démocratique, y compris lorsqu’elle relate des faits anciens.
Même l’erreur matérielle sur le montant des fonds détournés (300.000 € évoqués au lieu de 257.700 €) ne suffit pas à disqualifier l’article, la différence étant jugée non déterminante.
Pour rappel : les critères de la CEDH (affaire M.Y. c. Belgique, 2023)
Pour apprécier la légitimité du maintien d’une information dans le temps, la Cour européenne des droits de l’homme examine 7 critères :
1. Nature de l’information
2. Temps écoulé depuis les faits
3. Intérêt contemporain de l’information
4. Notoriété de la personne concernée
5. Répercussions négatives potentielles
6. Degré d’accessibilité de l’information
7. Impact de la mesure sur la liberté d’expression
En l’espèce, la Cour a considéré que la majorité de ces critères penchaient en faveur du maintien de l’article.
Une ligne rouge : la mémoire collective ne se réécrit pas à la demande
Cet arrêt s’inscrit dans une jurisprudence européenne de plus en plus structurée : le droit à l’oubli n’est pas absolu, et son exercice ne doit pas conduire à une réécriture de l’histoire publique.
Pour les professionnels du droit, les communicants ou les acteurs publics, cette décision est un signal clair : la gestion de l’identité numérique, même vingt ans après les faits, reste indissociable des principes démocratiques fondamentaux.
Certaines pages du passé ne se tournent pas à volonté : quand l’actualité devient mémoire collective, la presse reste un acteur essentiel de la démocratie.
Contactez TAoMA pour obtenir des conseils personnalisés ici.
Besoin de vous former ou de former vos équipes aux bonnes pratiques sur le sujet ?
Découvrez les ateliers de TAoMA Academy en nous contactant ici.
Gaëlle LOINGER-BENAMMRAN
Conseil en Propriété Industrielle Associée
Elsa OLCER
Juriste Stagiaire
1) CA Paris, pôle 4 – ch. 10, 20 févr. 2025, n° RG 21/12345
25
avril
2025
L’IA peut-elle écrire la loi ?
Author:
jcnicollet
Le 14 avril 2025, les Émirats arabes unis ont franchi une étape inédite en officialisant le lancement d’un écosystème législatif assisté par intelligence artificielle. Ce projet s’inscrit dans une stratégie de long terme engagée dès 2017 avec la nomination d’un ministre dédié à l’intelligence artificielle.
Avec la création d’un Bureau de l’intelligence réglementaire intégré à l’exécutif, l’objectif affiché est de fluidifier le processus législatif, d’améliorer la qualité des lois et de renforcer la cohérence du droit national. Le système repose sur une IA capable de consolider l’ensemble des textes juridiques existants, de détecter les contradictions ou lacunes, et de générer des projets de loi multilingues. Les autorités visent une réduction de 70 % des délais d’élaboration des normes.
L’IA est ici présentée comme un outil d’aide à la décision, sans pouvoir législatif autonome. Néanmoins, cette initiative soulève des interrogations majeures car si l’outil reste officiellement sous contrôle humain, il introduit une nouvelle forme d’influence algorithmique dans la production du droit.
Cette avancée technologique, bien que prometteuse en termes d’efficacité, interroge la manière dont les sociétés souhaitent articuler innovation, souveraineté normative et principes démocratiques. La production du droit engage des arbitrages humains, des valeurs et une vision du monde que la seule logique algorithmique ne peut embrasser pleinement.
Contactez TAoMA pour obtenir des conseils personnalisés ici.
Besoin de vous former ou de former vos équipes aux bonnes pratiques sur le sujet ?
Découvrez les ateliers de TAoMA Academy en nous contactant ici.
Anne MESSAS
Avocate à la Cour – Médiatrice – Associée
Elsa OLCER
Juriste Stagiaire
08
avril
2025
Constats sur internet : la norme AFNOR n’est pas la loi, rappelle la Cour d’appel d’Amiens
Dans une affaire1 opposant deux sociétés du secteur automobile à leur prestataire de création de sites internet, la Cour d’appel d’Amiens a eu l’occasion de préciser que le non-respect de la norme AFNOR NF Z67-147 lors de la réalisation d’un constat sur internet ne suffit pas à en entacher la validité. Un arrêt qui remet en lumière la valeur probatoire des constats numériques, indépendamment de leur conformité à une norme technique non contraignante.
Un litige numérique à plusieurs volets
Le contentieux opposait la SAS Lanie 02 et la SAS Optimise Car à leur prestataire, la SARL Be Ware Informatique, dans le cadre de la création, de l’hébergement et de la maintenance de deux sites internet. Malgré plusieurs réclamations et constats d’huissier mettant en cause la conformité et l’efficacité des sites livrés, la cour d’appel rejette la demande de résolution des contrats. Elle considère notamment que les dysfonctionnements invoqués ne sont pas suffisamment graves pour justifier une résolution judiciaire, les fonctionnalités essentielles ayant été assurées par le prestataire.
La norme AFNOR, un guide de bonnes pratiques mais sans force obligatoire
La Cour d’appel d’Amiens apporte une précision importante quant à la valeur des constats d’huissier réalisés sur Internet. Les sociétés clientes demandaient que soient écartés les constats produits par la partie adverse, arguant de leur non-conformité à la norme AFNOR NF Z67-147 du 11 septembre 2010, relative aux constats techniques sur internet.
La cour rejette cette argumentation et rappelle que cette norme n’a aucune valeur réglementaire. Elle constitue uniquement un recueil de bonnes pratiques à suivre par un commissaire de justice et destiné à sécuriser techniquement la réalisation de constats en ligne, mais son absence de respect n’équivaut pas à une irrégularité de procédure.
Ce rappel est important, à l’heure où les constats sur internet sont fréquemment utilisés comme preuves dans les litiges liés aux sites web, aux atteintes en ligne ou plus généralement, à la propriété intellectuelle.
Une appréciation pragmatique de la preuve
La cour s’appuie sur une approche concrète : d’une part, elle constate que les huissiers n’ont pas outrepassé leur mission en délivrant de simples constatations matérielles ; d’autre part, elle rejette la demande d’annulation des constats au motif qu’ils ne contiennent ni interprétation juridique, ni irrégularité manifeste.
Autre point notable : la cour valide le constat réalisé par la société défenderesse, bien que celui-ci ait été réalisé à distance (via Teams), avec l’assistance de sa chef de projet. Elle note que l’huissier a pris soin de sécuriser techniquement l’opération (description du matériel, adresse IP, copie du code source, etc.).
Un message clair pour les praticiens
La décision du 6 février 2025 envoie donc un signal clair : les juridictions ne subordonnent pas la recevabilité d’un constat sur internet au respect d’une norme technique, aussi réputée soit-elle. Cela ne signifie pas que tout constat serait valable, mais l’éventuelle non-conformité à la norme AFNOR ne peut, à elle seule, suffire à remettre en cause la force probante d’un constat, dès lors qu’il ne viole aucune exigence légale ou déontologique.
Alain HAZAN
Avocat à la Cour
1) CA Amiens, ch. éco., 6 février 2025, SARL Be Ware Informatique c/ SAS Lanie 02 et SAS Optimise Car
Contactez TAoMA pour obtenir des conseils personnalisés ici.
Besoin de vous former ou de former vos équipes aux bonnes pratiques sur le sujet ?
Découvrez les ateliers de TAoMA Academy en nous contactant ici.
24
février
2025
NFT la main dans le sac : après les USA, la justice française condamne la contrefaçon des sacs Hermès
Author:
TAoMA
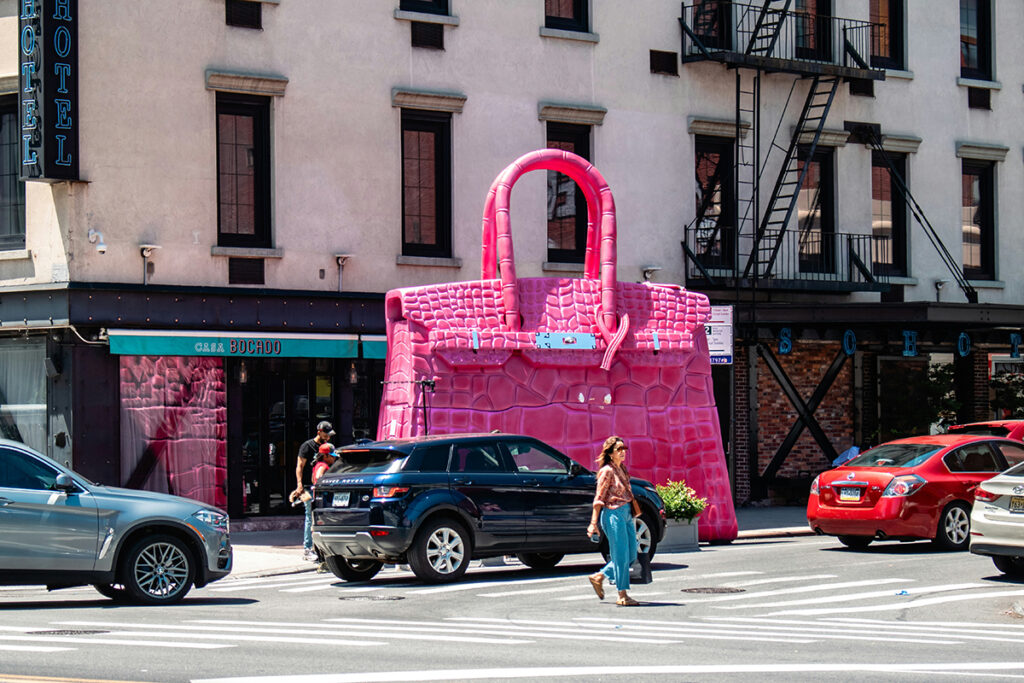
Contrefaçon des sacs Kelly et Birkin d’Hermès : le Tribunal judiciaire de Paris a condamné le 7 février 20251 la société Blao&Co pour contrefaçon du fait de la vente de sacs physiques et de NFT (Non-Fungible Token) représentant l’un de ces sacs sur la plateforme OpenSea.
Des sacs et NFT reproduisant les caractéristiques visuelles des modèles iconiques d’Hermès
Blao&Co vendait sous la marque NDG des sacs appelés Paisley Jane, reproduisant les caractéristiques visuelles des modèles d’Hermès :
• Même forme trapézoïdale avec soufflets latéraux.
• Système de fermeture similaire, avec un fermoir métallique et un cadenas.
• Design global proche du Kelly et du Birkin.
D’autre part, était en cause un NFT en vente sur OpenSea représentant l’un des sacs.
Hermès oppose ses droits sur les sacs iconiques
Hermès, revendiquait plusieurs droits :
• Les droits d’auteur sur les designs originaux des sacs Kelly et Birkin, sacs iconiques.
• Une marque tridimensionnelle protégeant l’aspect de certains éléments des sacs, notamment le fermoir et le cadenas.
Une décision de condamnation pour contrefaçon de droits d’auteur et de marque
Le tribunal a condamné Blao&Co pour contrefaçon de droits d’auteur et de marque en se fondant sur plusieurs points clés :
• L’originalité des sacs Kelly et Birkin
• La reproduction des caractéristiques essentielles de ces sacs, ce qui constitue une contrefaçon.
• L’argument du « fonds commun de la maroquinerie » n’a pas été retenu, car Hermès a démontré des éléments distinctifs spécifiques.
• L’existence d’un risque de confusion pour les consommateurs a été jugée suffisante pour établir la contrefaçon de marque.
Les NFT n’ont pas échappé à la sanction : Le tribunal a rejeté l’argument selon lequel un NFT serait un simple objet numérique indépendant et a estimé que :
• Le NFT constitue une reproduction du modèle protégé, même s’il s’agit d’un objet numérique.
• L’usage d’un NFT représentant un sac Hermès crée un risque de confusion chez les consommateurs, qui pourraient croire qu’il s’agit d’un produit authentique ou d’un projet approuvé par Hermès.
• La vente d’un NFT contrefaisant un produit physique constitue une exploitation commerciale non autorisée, assimilable à une contrefaçon classique.
• La commercialisation des NFT pouvait altérer l’image de prestige d’Hermès et créer une confusion sur l’authenticité des produits Hermès dans le métavers et sur le marché numérique.
• Le tribunal a confirmé que le simple fait qu’un NFT soit accessible depuis la France suffit à établir la compétence des juridictions françaises. L’argument selon lequel le NFT était uniquement destiné à un public international n’a pas été retenu.
Des sanctions lourdes ont été prononcées : Blao&Co a été condamnée à 220000 € de dommages et intérêts, au rappel des sacs, et à supprimer le NFT de la plateforme OpenSea.
Quel lien avec l’affaire Mason Rothschild aux États-Unis ?
Cette décision fait écho au procès américain de février 2023, où Hermès a également gagné contre l’artiste Mason Rothschild, qui vendait des NFT « MetaBirkins », des versions numériques stylisées du sac Birkin. La justice américaine avait estimé que ces NFTs portaient atteinte à la marque Hermès, rejetant l’argument selon lequel il s’agissait d’une œuvre d’art protégée par le Premier Amendement.
Comme dans l’affaire Blao&Co en France, la justice a retenu que la reproduction des sacs Hermès sous forme de NFT pouvait induire les consommateurs en erreur et porter atteinte aux droits de propriété intellectuelle de la marque.
NFT : Toujours en vogue ou en perte de vitesse ?
Cette décision intervient dans un contexte où les NFT ont perdu en popularité depuis leur pic de 2021-2022. La spéculation sur les NFT a chuté, et de nombreuses plateformes, dont OpenSea, ont réduit leurs effectifs face à la baisse du marché. Toutefois, les marques de luxe continuent d’explorer les NFT, notamment pour certifier l’authenticité de produits physiques ou créer des expériences exclusives.
Le NFT n’est pas une zone de non-droit.
Cette affaire confirme que les NFT ne sont pas une zone de non-droit, et que la contrefaçon numérique peut être poursuivie comme la contrefaçon physique. La convergence entre propriété intellectuelle et blockchain pose des défis que les tribunaux, tant en France qu’aux États-Unis, commencent à encadrer avec des décisions qui instaurent un cadre juridique plus clair et constant.
Anne MESSAS
Avocate à la Cour, Médiatrice
Vous avez des questions sur la protection et la défense de vos créations numériques ou physiques ? Contactez TAoMA pour obtenir des conseils personnalisés ici.
Besoin de vous former ou de former vos équipes aux bonnes pratiques sur le sujet ?
Découvrez les ateliers de TAoMA Academy en nous contactant ici.
1) TJ Paris 7 février 2025
11
février
2025
« Glashütte Original » : dure réalité pour l’horlogerie virtuelle
Author:
TAoMA
Le Tribunal de l’Union européenne (TUE) a rendu une décision le 11 décembre 2024 dans l’affaire T-1163/23, qui porte sur l’appréciation du caractère distinctif d’une marque déposée pour des produits virtuels. Cette affaire, concernant la marque figurative , n° 018727034, constitue une première en matière de marques de l’Union européenne appliquées à des produits exclusivement numériques. Elle met en lumière la question du transfert de notoriété entre produits réels et virtuels et les conséquences en termes de distinctivité.
Un refus fondé sur le manque de distinctivité
La marque contestée, « Glashütte ORIGINAL (fig.) », avait été déposée pour des produits virtuels téléchargeables (montres et horloges virtuelles, accessoires horlogers) en classe 9, ainsi que pour des services de vente au détail et de fourniture de ces produits virtuels en classes 35 et 41. L’EUIPO avait refusé l’enregistrement au motif que le signe était dépourvu de caractère distinctif, car il évoquait la ville de Glashütte, reconnue pour son industrie horlogère de haute précision. Pour se faire, l’EUIPO a cependant jugé que le public pertinent à prendre en compte pour son analyse est le public allemand.
Le Tribunal confirme cette analyse en considérant que la notoriété de la ville de Glashütte dans le domaine horloger est un fait notoire en Allemagne et que le terme « original » ne confère aucun élément distinctif supplémentaire. Ce dernier terme évoquerait « l’idée d’authenticité et de fidélité à l’original ». L’ensemble du signe est donc perçu comme un « héritage de savoir-faire exceptionnel et une réputation d’excellence […] » plutôt que comme une indication d’origine commerciale.
L’équivalence entre produits réels et virtuels
Un des apports essentiels de cette décision réside dans l’application des mêmes critères de distinctivité aux produits virtuels qu’aux produits physiques correspondants. Le Tribunal affirme que lorsque des produits virtuels reproduisent ou émulent des produits réels, la perception du public pertinent reste identique. Il y a un « transfert de la perception qu’a le public pertinent des produits et services réels vers les produits et services virtuels ».
Le Tribunal rappelle que l’analyse doit se faire au cas par cas mais, en général, si une indication est perçue comme non distinctive pour des produits physiques, elle le sera également pour des produits virtuels qui représentent ces objets réels.
Une jurisprudence appelée à évoluer
Bien que l’affaire Glashütte ORIGINAL porte uniquement sur un motif absolu de refus et non sur la similarité entre produits et services, elle illustre la tendance des juridictions à ne pas cloisonner les réalités physique et virtuelle. Cette approche pourrait influencer l’évolution de la jurisprudence en matière de contrefaçon et de coexistence des marques entre ces deux sphères.
Conclusion
L’affaire Glashütte ORIGINAL est une décision importante sur le caractère distinctif des marques pour produits virtuels. Elle met en évidence la tendance des juridictions à appliquer aux marques virtuelles les mêmes critères de distinctivité qu’aux marques pour produits physiques lorsque les premiers reproduisent ou émulent les seconds.
Le temps dira si cette approche s’impose dans la jurisprudence, mais pour l’instant, l’horlogerie virtuelle semble devoir retarder ses ambitions réelles.
Elsa OLCER
Juriste Stagiaire
Jean-Charles NICOLLET
Conseil en Propriété Industrielle Associé
Contactez TAoMA pour obtenir des conseils personnalisés ici.
Besoin de vous former ou de former vos équipes aux bonnes pratiques sur le sujet ?
Découvrez les ateliers de TAoMA Academy en nous contactant ici.
(1) TUE, 1re ch., 11 déc. 2024, n° T-1163/23
14
octobre
2024
Urgence face à l’émergence des Deepfakes
Author:
TAoMA
Dans un rapport publié le 9 juillet 2024, le Copyright Office des États-Unis préconise l’adoption d’une nouvelle loi fédérale pour encadrer l’utilisation des répliques numériques (Deepfakes) générées par l’intelligence artificielle (IA)1.
Cette recommandation intervient dans un contexte où la technologie permet de recréer des voix ou des images humaines de manière incroyablement réaliste, soulevant de nombreuses inquiétudes.
UNE RÉPONSE NÉCESSAIRE FACE AUX PROGRÈS DE L’IA
Bien que les Deepfakes ne soient pas nouveaux, les récentes avancées en intelligence artificielle ont facilité leur diffusion à grande échelle. L’exemple emblématique cité est celui de la chanson « Heart on My Sleeve », qui imitait parfaitement les voix de Drake et The Weeknd sans leur autorisation, et qui a cumulé des millions d’écoutes avant d’être retirée des plateformes.
À l’origine de vidéos innocentes comme celles de célébrités « chantant » ou « jouant » dans des contextes fictifs, ces outils ne se limitent pas à des usages innocents. Ils sont de plus en plus détournés à des fins nuisibles, ce qui met en lumière les lacunes actuelles de notre cadre juridique. Des voix ou des images de personnalités publiques sont imitées pour influencer les électeurs, promouvoir des produits sans consentement, ou encore créer des vidéos pornographiques.
Devant la montée en puissance de ces dérives, le Copyright Office considère que les lois existantes ne sont plus en mesure d’offrir une protection suffisante contre l’utilisation non autorisée de l’image ou de la voix de toute personne, qu’il s’agisse de personnalités publiques comme des artistes, politiciens ou de particuliers. L’agence recommande donc l’adoption d’une nouvelle loi fédérale spécifiquement dédiée à cette problématique.
UN CADRE JURIDIQUE INADEQUAT FACE AUX REPLIQUES NUMERIQUES
Le rapport souligne que le cadre juridique actuel aux États-Unis est insuffisant pour répondre à la menace que représentent ces répliques numériques non autorisées. Malgré l’existence de lois sur les droits à la vie privée et à la publicité, l’absence d’une législation fédérale spécifique rend difficile l’application de sanctions contre les créateurs de Deepfakes. Seuls quelques États ont pris des mesures, tandis que les victimes de Deepfakes se retrouvent souvent sans recours.
Face à ces défis croissants, les législateurs se mobilisent. Le Congrès a ainsi commencé à examiner plusieurs projets de loi, dont le NO AI FRAUD Act et le NO FAKES Act, qui visent à combler ces lacunes. Ces propositions prévoient une protection juridique contre l’utilisation non autorisée de répliques numériques réalistes, y compris des voix ou des images générées par IA, avec des sanctions sévères pour les contrevenants.
Les Deepfakes représentent un équilibre délicat entre innovation technologique et protection des droits individuels. Si ces répliques peuvent avoir des fins créatives, comme ressusciter des artistes décédés ou permettre à des personnes handicapées de retrouver leur voix, elles sont également utilisées à des fins malveillantes. L’impact sur les artistes, les créateurs, et plus largement sur le public, est considérable.
Au-delà des impacts individuels, l’usage malveillant des Deepfakes menace également des institutions fondamentales. La création de contenu trompeur compromet la confiance du public dans les médias et les processus démocratiques. Par exemple, des voix clonées de politiciens ont été utilisées dans des tentatives de manipulation électorale. Les conséquences de telles actions sur la démocratie et la liberté d’expression sont graves, et les experts craignent que la technologie des Deepfakes ne rende bientôt impossible la distinction entre le vrai et le faux.
Le rapport analyse en détail les limites des cadres juridiques actuels face à cette nouvelle problématique. Au niveau des États, les droits à la vie privée et à l’image offrent une protection variable et fragmentée. Au niveau fédéral, ni le droit d’auteur, ni les lois sur la concurrence déloyale ou les communications ne sont pleinement adaptés.
Conscient de l’ampleur du phénomène, le Copyright Office appelle à une réponse rapide à l’échelle fédérale pour mieux encadrer ces répliques numériques. Sans un recours solide à l’échelle nationale, leur diffusion non autorisée menace de causer des préjudices importants, non seulement dans les domaines du divertissement et de la politique, mais aussi pour les simples particuliers.
VERS UNE MEILLEURE PROTECTION DES INDIVIDUS A L’ERE DU NUMERIQUE
Cette recommandation s’inscrit dans une réflexion plus large sur la régulation de l’IA aux États-Unis. Si elle aboutissait, cette nouvelle loi fédérale marquerait un tournant décisif dans la protection des individus face aux risques croissants liés aux Deepfakes et à l’IA. Elle garantirait une protection homogène à l’échelle nationale tout en laissant aux États la possibilité de renforcer ces mesures par des protections locales adaptées.
Le rapport du Copyright Office devrait alimenter les débats au Congrès, où plusieurs propositions législatives, telles que le NO AI FRAUD Act et le NO FAKES Act, sont déjà à l’étude. La question centrale reste de savoir comment le législateur américain parviendra à concilier la nécessité de protéger les individus et la vie privée, avec les impératifs d’innovation technologique et de liberté d’expression.
Alors que les États-Unis tâtonnent encore pour adapter leur législation face à ces nouvelles menaces, l’Union européenne a pris une longueur d’avance en adoptant le Règlement (UE) 2024/16892, qui impose des règles harmonisées pour encadrer les systèmes d’intelligence artificielle. Ce texte vise à assurer la sécurité des citoyens tout en protégeant leurs droits fondamentaux, sans pour autant freiner l’innovation.
Contrairement aux approches fragmentées des États-Unis, qui s’appuient sur des initiatives législatives spécifiques, l’UE a opté pour un cadre global. Ce règlement impose des exigences strictes en matière de transparence, de gestion des risques, et de surveillance des systèmes IA à haut risque, comme les technologies de Deepfakes. L’objectif est clair : protéger les citoyens tout en maintenant un équilibre entre la créativité technologique et la liberté d’expression.
En conclusion, l’émergence des Deepfakes présente des défis inédits pour la protection des droits individuels à l’ère numérique. Si la technologie ouvre des horizons créatifs fascinants, elle comporte également des dangers considérables pour la vie privée, la sécurité, voire les institutions. Les initiatives législatives proposées par le Copyright Office aux États-Unis et le cadre réglementaire européen sur l’intelligence artificielle sont des réponses cruciales à ces enjeux. À mesure que l’IA continue de se développer, il devient impératif de trouver un juste équilibre entre l’innovation et la protection des droits fondamentaux.
Contactez TAoMA pour obtenir des conseils personnalisés ici.
Besoin de vous former ou de former vos équipes aux bonnes pratiques sur le sujet ?
Découvrez les ateliers de TAoMA Academy en nous contactant ici.
Elsa OLCER
Juriste Stagiaire
Jean-Charles NICOLLET
Conseil en Propriété Industrielle Associé
Contactez TAoMA pour obtenir des conseils personnalisés ici.
Besoin de vous former ou de former vos équipes aux bonnes pratiques sur le sujet ?
Découvrez les ateliers de TAoMA Academy en nous contactant ici.
1) https://www.copyright.gov/ai/Copyright-and-Artificial-Intelligence-Part-1-Digital-Replicas-Report.pdf
09
avril
2024
En avant vers la régulation des systèmes d’intelligence artificielle
Dès octobre 20201, le Conseil Européen avait mis en avant l’objectif pour l’UE de devenir « un acteur mondial de premier plan dans le développement d’une intelligence artificielle sûre, fiable et éthique ».
La Commission Européenne a publié, le 21 avril 2021 sa proposition de règlement, l’IA Act, établissant un ensemble de règles harmonisées sur l’intelligence artificielle, qui a été adopté par le Conseil de l’Union Européenne fin 2022.
Dans la continuité du parcours législatif, un accord provisoire a été conclu entre le Parlement Européen et le Conseil, le 9 décembre 2023, après 3 jours de négociations.
La législation est finalement adoptée le mercredi 13 mars 2024, par une large majorité des députés européens.
Mais quels sont les apports principaux de ce texte ?
Entre neutralité technologique du droit et régulation asymétrique
L’IA Act adopte une définition très large pour englober tous les systèmes d’IA et ne pas devenir obsolète aux grés des évolutions technologiques : ainsi, il le définit comme étant « un système basé sur une machine conçu pour fonctionner avec différents niveaux d’autonomie, qui peut s’adapter après son déploiement et qui, pour des objectifs explicites ou implicites, déduit, à partir des données qu’il reçoit, comment générer des résultats tels que des prédictions, du contenu, des recommandations ou des décisions qui peuvent influencer des environnements physiques ou virtuels ».
Si le texte se veut applicable à un large spectre de systèmes d’IA, il propose, paradoxalement, un champ d’application asymétrique, venant relativiser la neutralité technologique revendiquée.
En effet, cette législation fonctionne selon une approche basée sur le risque : les risques sont classifiés en trois niveaux, allant de l’inacceptable au minimal, ayant chacun un régime juridique spécifique.
Si les systèmes d’IA à risques faibles ne sont soumis qu’à une réglementation légère3, les applications d’IA « à haut risque » et les systèmes d’IA à « risques inacceptables » sont, eux, beaucoup plus impactés.
Les systèmes IAs à haut risque sont règlementées
Les IAs à haut risque sont les IAs qui présentent des risques importants pour la santé, la sécurité ou les droits fondamentaux des personnes. L’IA Act lui consacre son Titre III.
Dans un premier temps, sont considérés comme IA à haut risque, « les systèmes d’IA destinées à être utilisées comme composant de sécurité ou qui constituent un tel produit, faisant l’objet d’une évaluation ex ante de la conformité par un tiers ».
Également, est prévu, en Annexe III, une liste limitative de systèmes d’IA à haut risque, dont la Commission Européenne se réserve la possibilité d’y ajouter de nouveaux systèmes, afin de rester pertinent face à l’évolution des technologies4.
Ces IAs sont en principe autorisées sur le marché européen, sous réserve d’être conformes à la réglementation fixée par le Chapitre 2 du Titre III du texte. Ces exigences portent sur plusieurs aspects, tels que la mise en place d’un système de gestion des risques ainsi que la gestion et la gouvernance des données, mais aussi la documentation et la tenue de registres, la transparence et l’information des utilisateurs, le contrôle humain, la robustesse ou encore l’exactitude et la (cyber)sécurité des systèmes.
Ces obligations s’adressent surtout aux fournisseurs de systèmes d’IA. Néanmoins, les utilisateurs, les fabricants, ou les autres tiers ne sont pas en reste et sont également soumis à des obligations, décrites dans le Titre III !
Les IAs à risque inacceptable sont (en principe) interdites.
Le Titre II prévoit une liste de pratiques interdites : cela concerne les systèmes d’IA dont l’utilisation est considérée comme inacceptable, car contraire aux valeurs de l’Union, notamment en raison des violations des droits fondamentaux qu’elle est susceptible d’engendrer.
Sont par exemples interdites5 :
– Les « systèmes d’IA qui utilisent des techniques subliminales échappant à la conscience d’une personne ou des techniques délibérément manipulatrices ou trompeuses, ayant pour objectif ou pour effet de fausser de manière significative le comportement d’une personne ou d’un groupe de personnes en altérant sensiblement la capacité de la personne à prendre une décision en connaissance de cause, (…) »
– Les « systèmes d’IA pour l’évaluation ou la classification de personnes physiques ou de groupes de personnes sur une certaine période de temps, sur la base de leur comportement social ou de leurs caractéristiques personnelles ou de personnalité connues, déduites ou prédites, le score social conduisant » à un préjudice.
Il existe une exception concernant l’utilisation d’un système d’identification biométrique à distance en « temps réel » dans des espaces accessibles au public (apparaissant dans la liste des pratiques interdites), qui pourra être autorisé lorsqu’il est utilisé à des fins répressives. Évidemment, cette exception doit respecter des conditions de nécessité et de proportionnalité !
Les systèmes d’intelligence artificielle qui comportent des risques spécifiques de manipulation sont régis par un cadre réglementaire particulier.
Ce régime spécifique concerne certains systèmes d’IA, notamment ceux destinés à interagir avec des personnes physiques ou à générer du contenu. Ce régime intervient au-delà de la classification des risques, c’est-à-dire que même un système d’IA à risque faible peut être soumise à ce régime de transparence.
Ces systèmes seront soumis à des obligations de transparence spécifiques6.
On peut par exemple mentionner, au titre de ces obligations additionnelles, celle d’information des personnes qu’elles interagissent avec un système d’IA ou encore celle d’information des personnes qu’elles sont exposées à un système de reconnaissance des émotions. Également, le règlement prévoit le cas des « deep fakes7 », pour lesquels il sera obligatoire, sauf exceptions, de déclarer que le contenu est généré par des moyens automatisés.
Conclusion
L’IA Act est un texte dense, qui tente de réglementer les systèmes d’intelligence artificielle, avec pour finalité, de limiter les risques associés à l’utilisation de l’IA et à créer un écosystème de confiance autour de cette technologie.
Il est important de souligner que l’intention n’est pas de créer une réglementation pesant lourdement sur les entreprises ou toute personnes à l’initiative d’un système d’intelligence artificielle. En effet, l’objectif est de se limiter « aux exigences minimales nécessaires » pour répondre aux risques de l’IA, sans pour autant « restreindre ou freiner indûment le développement technologique, ni augmenter de manière disproportionnée les coûts de mise sur le marché de solutions d’IA »8.
C’est d’ailleurs la raison pour laquelle le texte réduit la charge réglementaire pesant sur les PME et les start-up ; et instaure la mise en place de bacs à sables réglementaires offrant un environnement contrôlé qui facilite le développement, la mise à l’essai et la validation des systèmes d’IA9.
Désormais, ce texte doit être adopté officiellement par le Conseil ! La législation entrera en vigueur 20 jours après sa publication au Journal officiel et sera entièrement applicable 24 mois après, à l’exception de certaines dispositions qui entreront en vigueur plus tôt, ou plus tard.
N’oublions pas toutefois que l’IA se développe de jour en jour et n’en est qu’à ses débuts ! Les applications quotidiennes sont aussi nombreuses que les risques qu’elles pourraient engendrer. Dans ce contexte, l’UE innove en tentant de limiter ces risques, sans pour autant limiter le développement de l’intelligence artificielle.
La Team de TAoMA est à votre disposition pour toute question sur ce sujet !
Juliette Danjean
Stagiaire juriste
Jean-Charles Nicollet
Conseil en Propriété Industrielle Associé
1) Réunion extraordinaire du Conseil européen (1er et 2 octobre 2020)
2) Article 3 Titre I de la dernière version du Règlement
3) Voir Titre IX et son article unique, qui encourage les fournisseurs de systèmes d’IA à tenir des codes de conduite, visant à inciter les fournisseurs de systèmes d’intelligence artificielle qui ne représentent pas un risque élevé à adopter volontairement les exigences imposées aux systèmes d’IA à haut risque, telles que définies dans le titre III.
4) Les systèmes d’IAs figurant dans le texte pour le moment, concernent par exemple les systèmes d’IA concernant l’identification biométrique et catégorisation des personnes physiques ou encore les systèmes de gestion et exploitation des infrastructures critiques (gestion et l’exploitation du trafic routier, fourniture d’eau, de gaz, de chauffage et d’électricité).
5) Voir Article 5 Titre II de la dernière version du Règlement
6) Voir Titre IV de la dernière version du Règlement
7) Selon le Parlement Européen, « les «deep fake» sont le résultat de la manipulation d’un média par l’intelligence artificielle », ce sont des « hypertrucages qui altèrent la réalité » (https://multimedia.europarl.europa.eu/fr/audio/deepfake-it_EPBL2102202201_EN)
8) Exposé des motifs de la Proposition de règlement de la Commission Européenne (1 ; 1.1)
9) Voir Titre V de la dernière version de Règlement
Load more
Loading...